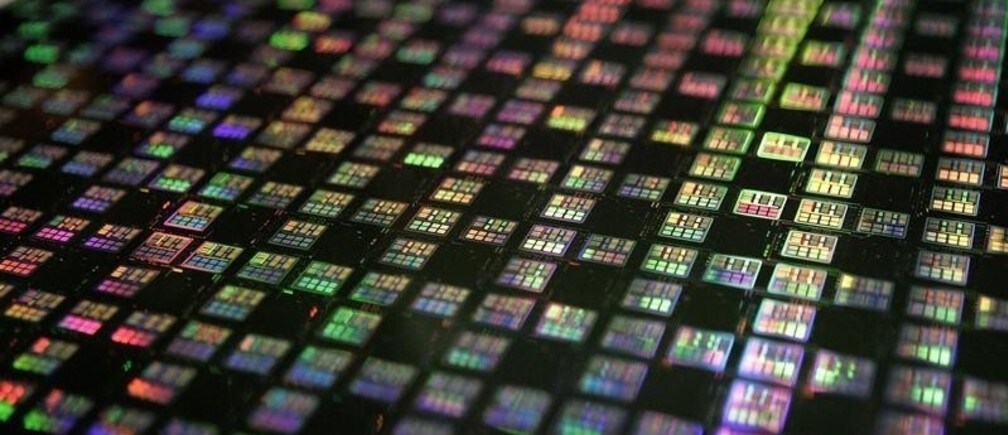
コンピューターチップのクロック速度は、もはや上がらなくなっています。性能向上を続けるため、チップメーカーは代わりに、並列に計算を実行できる処理ユニット、すなわちコアの数を増やしています。
しかし、チップが計算をどのように分割するかによって、性能は大きく変わることがあります。2013年の論文で、MIT電気工学・コンピューターサイエンス学科のTIBCO創設者助教であるDaniel Sanchezと、同氏の学生Nathan Beckmannは、マルチコアチップのメモリーバンク間にデータを巧みに分散するシステムを説明しました。このシステムは、実行時間を平均18%短縮すると同時に、エネルギー効率も向上させます。
今月、電気電子学会(IEEE)の高性能コンピューターアーキテクチャ国際シンポジウムで、Sanchezの研究グループのメンバーが、データだけでなく計算の分散も制御するようシステムを拡張した研究で、最優秀論文賞の候補に選ばれました。64コアチップを用いたシミュレーションでは、このシステムにより消費電力を36%削減しながら、計算速度が46%向上しました。
「性能を向上させるにはコアを増やし、より大規模な並列システムへ移行するという状況になり、ボトルネックの中心は通信とメモリーアクセスだということが、はっきりと分かってきました」とSanchezは話します。「前のプロジェクトで私たちが取り組んだことの大部分は、データを計算の近くに配置することでした。しかし、計算をどう配置するかが、その近くにデータをどれだけうまく配置できるかに大きな影響を与えることが分かったのです。」
切り分け
計算とデータを同時に割り当てる問題は、チップ設計における代表的な問題の一つ「配置配線」によく似ています。配置配線問題では、まず一連の論理回路が指定され、それらと連携して動作する回路要素間の距離が最小になるよう、チップ上に配置することを目指します。
この問題は「 NP困難」として知られています。つまり、少なくとも現時点で知られている限り、たとえ中程度の規模のチップでも、世界中のコンピューターを総動員して最適解を探しても、宇宙の寿命が尽きるまでに見つけられないということです。しかしチップメーカーは、絶対的な最適解ではないものの、実際にはうまく機能すると思われるアルゴリズムをいくつも開発してきました。
64コアチップ上で計算とデータを割り当てる問題にこれらのアルゴリズムを適用すると、解を得るまでに数時間かかります。SanchezとBeckmann、そしてSanchezの研究グループの別の学生Po-An Tsaiは、独自のアルゴリズムを開発しました。このアルゴリズムは、標準的な配置配線アルゴリズムが導き出す解と比べて、効率が99%を超える解を見つけます。それも、ミリ秒単位で実行できます。
「私たちはまず、データをおおまかに配置します」とSanchezは話します。「データが一つの領域に集中したり、[メモリー]バンクの一部に過剰な負荷がかかったりしないように分散します。次に、[計算]スレッドをデータの近くに配置する方法を決め、そのスレッドの配置に合わせてデータの配置を調整します。この3段階の方法によって、問題を切り分けるのです。」
原理的には、Beckmannが付け加えるように、データ配置に合わせて計算を再び割り当てるなど、このプロセスを繰り返すこともできます。「しかし、私たちは1%を達成したので、そこで止めました」と彼は言います。「結局のところ、そういうことです。」
動向を把握する
MITの研究者たちのシステムは、チップの動作を監視し、25ミリ秒ごとにデータとスレッドを再割り当てします。これは短い時間に思えますが、コンピューターチップが5,000万回の演算を行うには十分な長さです。
その間、モニターは各コアがメモリーに送るリクエストを無作為にサンプリングし、要求されたメモリー位置を略式で専用のメモリー回路に保存します。
チップ上の各コアには独自のキャッシュがあります。頻繁に使うデータを保存する、ローカルの高速メモリーバンクです。サンプルに基づいて、モニターは各コアが必要とするキャッシュ容量を推定し、どのコアがどのデータにアクセスしているかを追跡します。
このモニターはチップ面積の約1%を占めます。その面積は、代わりに演算回路の追加に割り当てることもできます。しかしSanchezは、チップメーカーにとって、性能を大幅に向上させるために支払う対価としては小さいと考えられるだろうと述べています。
「米国科学アカデミーによる大規模な研究と、DARPAが後援した[情報科学技術]の研究では、計算より通信が支配的になることの重要性が取り上げられました」と、ウィスコンシン大学マディソン校のコンピューターサイエンス教授David Woodは言います。「こうした研究の一部から分かるのは、計算そのものよりも、オペランドを計算の場所まで移動させることで、桁違いに多くのエネルギーが消費されるということです。場合によっては2桁も違います。つまり、それをしないようにする必要があるのです。」
MITの研究者たちは「実用的な問題で機能すると思われる提案をしており、非常に目覚ましい成果を上げることができます」とWoodは言います。「これは重要な問題であり、結果は大いに有望です。」
この記事は、 MIT Newsとの協力により掲載されています。掲載は、世界経済フォーラムがその見解を支持することを意味するものではありません。
アジェンダの最新情報をお届けする 週刊ニュースレターに登録してください。
著者:Larry HardestyはMIT Newsの寄稿者です。
画像:2007年1月9日、新竹の台湾積体電路製造(TSMC)で、12インチウエハーが展示されている。REUTERS/Richard Chung。


