AIアルゴリズムにおけるバイアスや誤りのリスクは広く知られているにもかかわらず、テック企業はAIチャットボットや画像生成ツールで数多くの失敗を重ねてきました。
AIにバイアスが生じる原因として考えられるのは、学習データを代表性の乏しい集団が提供していることであり、その結果、精度と公平性の間にトレードオフが生じています。
あるテクノロジー分野の教授は、意図せずバイアスのあるAIアルゴリズムを作ってしまった自身の経験を通じて、包摂的なアルゴリズムを作るうえで多様性がいかに重要かを強調しています。
1998年、私は意図せず人種的なバイアスを持つ人工知能アルゴリズムを作ってしまいました。その話には、今日さらに強く共鳴する教訓が含まれています。
次のリスクはAIアルゴリズムにおけるバイアスや誤りとしてすでによく知られています。それでは、なぜここ数カ月、テック企業の失態が相次いでいるのでしょうか。特にAIチャットボットや画像生成ツールの分野で顕著です。ChatGPTの初期版は人種差別的な出力を生み出しました。DALL-E 2とStable Diffusionという画像生成ツールは、いずれも生成した画像に人種的バイアスを示しました。
白人男性であるコンピューター科学者としての私の気づきは、コンピューター科学者として2021年にコンピューター科学の授業を教えていた際に訪れました。授業では、AI研究者でありアーティストでもあるJoy Buolamwiniによるビデオ詩を視聴したばかりでした。AI研究者・アーティストであり、自らコードの詩人と称する人物です。彼女による2019年のビデオ詩「AI、私は女性じゃないの?」は、Google や Microsoft などのテック企業が開発した自動顔認識システムにおける人種的・ジェンダー的バイアスを、3分間にわたり痛烈に暴いた作品です。
これらのシステムは、有色人種の女性を誤って男性と判定することがよくあります。特に深刻な誤認識もあり、黒人の公民権運動指導者Ida B. Wellsの髪が「アライグマの毛皮の帽子」とラベル付けされ、別の黒人女性は「セイウチの口ひげ」を生やしていると判定されました。
時代を超えて響く声
そのコンピューター科学の授業で、私は強い既視感に襲われました。私自身もかつて人種的バイアスのあるアルゴリズムを作ったことを、突然思い出したのです。1998年、私は博士課程の学生でした。私の研究テーマは、ビデオカメラの入力に基づいて人の頭部の動きを追跡することでした。指導教員はすでに、特定の状況で頭部を正確に追跡するための数学的手法を開発していましたが、システムはさらに高速で頑健である必要がありました。1990年代初頭には、他の研究室の研究者たちが、画像内の肌色の領域をリアルタイムで抽出できることを示していました。そこで私たちは、トラッカーの追加的な手がかりとして肌の色に注目することにしました。
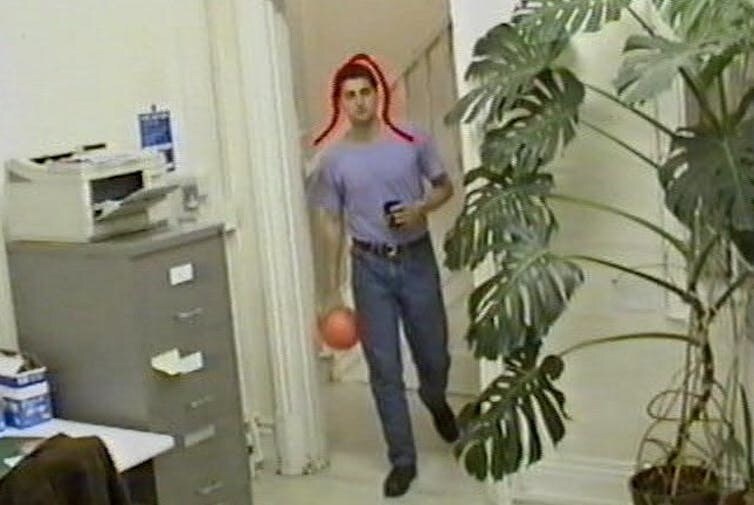
当時はまだ珍しかったデジタルカメラを使い、自分の手と顔、さらに建物内にたまたまいた2、3人の他の人の手と顔を撮影しました。これらの画像から肌色のピクセルを手作業で抽出し、肌の色の統計モデルを構築するのは簡単でした。微調整とデバッグを経て、驚くほど頑健なリアルタイムの頭部追跡システムが完成しました。
その後まもなく、指導教員から、訪問中の企業の役員たちにシステムを実演するよう頼まれました。彼らが部屋に入ってきたとき、私は即座に不安に襲われました。役員たちは日本人だったのです。プロトタイプに単純な統計モデルが機能するかを確かめる気軽な実験では、私自身と建物内にたまたまいた数人のデータしか集めていませんでした。しかし、これらの被験者の100%が「白人」の肌色であり、日本人役員はそうではありませんでした。
それにもかかわらず、システムは役員たちに対しても驚くほどよく機能しました。しかし、私は、白人以外の人々に対して容易に機能しなくなり得る、人種的バイアスのあるシステムを作ってしまったという事実に衝撃を受けました。
特権と優先順位
よく教育を受け、善意を持つ科学者が、なぜ、どのようにしてバイアスのあるAIシステムを生み出してしまうのでしょうか。特権に関する社会学的理論が、一つの有用な視点を提供してくれます。
私が頭部追跡システムを作る10年前、学者のPeggy McIntoshは、白人が持ち歩く「見えないリュックサック」という概念を提唱しました。そのリュックサックの中には、「困難な状況でも、自分の人種のおかげだと言われることなく、うまくやれる」や「政府を批判し、その政策や行動をどれほど恐れているかを語っても、文化的な部外者とみなされることはない」といった数々の特権が詰まっています。
AIの時代においては、そのリュックサックには「AIシステムは私の人種のせいで低い結果を出すことはない」といった新たな要素が必要です。白人の科学者の見えないリュックサックには、さらに「自分自身の外見に基づいたAIシステムを開発でき、それがほとんどの利用者に対してうまく機能すると分かっている」という要素も必要でしょう。
白人の特権に対する一つの提言は、積極的に反人種差別的であることです。1998年の頭部追跡システムについて言えば、反人種差別的な解決策は、すべての肌の色を平等に扱うことだと考えるのが当然に思えるかもしれません。確かに、システムの学習データが、すべての肌の色の範囲を可能な限り均等に反映するよう確保することはできますし、そうすべきです。
残念ながら、これではシステムが認識するすべての肌の色が平等に扱われる保証にはなりません。システムは、あらゆる可能な色を肌色か非肌色のいずれかに分類しなければなりません。そのため、肌色と非肌色の境界線上に位置する色が必ず存在し、コンピューター科学者はこれを決定境界と呼ぶ領域として扱っています。この決定境界をまたぐ肌の色を持つ人は、誤って分類されることになります。
また、機械学習モデルに多様性を取り入れる際、科学者は厄介な潜在意識のジレンマにも直面します。多様で包摂的なモデルは、狭いモデルよりも性能が低いのです。
単純な例えで説明できます。二つの課題のどちらかを選ぶよう求められたと想像してください。課題Aは、特定の一種類の木、例えばニレを識別することです。課題Bは、ニレ、トネリコ、イナゴマメ、ブナ、クルミの5種類を識別することです。一定の練習時間が与えられた場合、課題Aの方が課題Bよりも良い成績を出せることは明らかです。
同様に、白い肌だけを追跡するアルゴリズムは、人間の肌の色の全範囲を追跡するアルゴリズムよりも正確になります。科学者は多様性と公平性の必要性を認識していても、この正確さへの競合する要求によって、潜在意識のうちに影響を受けることがあります。
数字に隠されたもの
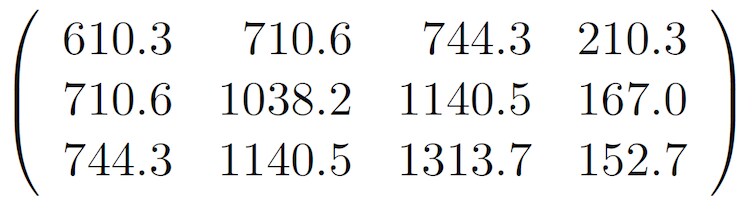
私がバイアスのあるアルゴリズムを作ったことは、思慮に欠けており、潜在的に不快なものでした。さらに懸念すべきことに、この事例は、バイアスがAIシステムの奥深くに隠れたまま残り得ることを示しています。その理由を理解するために、3行4列の行列にある12個の数字の組を考えてみてください。これらは人種差別的に見えるでしょうか。私が1998年に開発した頭部追跡アルゴリズムは、肌の色のモデルを表すこのような行列によって制御されています。しかし、これらの数字だけを見て、これが実際に人種差別的な行列であると見分けることは不可能です。それらは単にコンピュータープログラムによって自動的に決定された数字にすぎません。
バイアスが明白な形ではなく隠れた形で存在する問題は、現代の機械学習システムではさらに深刻です。深層ニューラルネットワークは、現在最も普及し強力なタイプのAIモデルですが、バイアスが符号化され得る数百万の数字を持つことがよくあります。「AI、私は女性じゃないの?」で批判された顔認識システムは、いずれも深層ニューラルネットワークです。
朗報として、AIの公平性に関しては、学術界と産業界の双方で、すでに大きな進展が見られます。例えばMicrosoftには、AIにおける公平性、説明責任、透明性、倫理に取り組むFATEという研究グループがあります。主要な機械学習会議であるNeurIPSは、論文を投稿する研究者が考慮すべき、社会への悪影響を8項目にまとめたリストを含む倫理ガイドラインを詳細に示しています。
部屋にいる人が、テーブルにつく人である
一方で、2023年になってもなお、学術界や産業界における競争上の圧力によって、公平性が犠牲になることがあります。Googleと Microsoftによる欠陥のあるBardとBingのチャットボットは、この厳しい現実を示す最近の証拠です。市場シェアを獲得する商業上の必要性から、これらのシステムは時期尚早に公開されました。
これらのシステムは、私の1998年の頭部追跡システムとまったく同じ問題を抱えています。学習データにはバイアスがあります。代表性の乏しい集団によって設計されています。すべてのカテゴリを平等に扱うことは数学的に不可能です。何らかの形で精度と公平性を取引しなければなりません。そして、そのバイアスは、数百万の理解しがたい数値パラメーターの陰に隠れています。
では、25年以上前に、博士課程の学生が、明白な監督も結果もなしに人種的バイアスのあるアルゴリズムを設計し、その結果を発表することが可能だった時代から、AI分野は本当にどこまで進歩したのでしょうか。バイアスのあるAIシステムは、今なお意図せずに、容易に作られ得ることは明らかです。また、これらのシステムにおけるバイアスは有害であり、検出は困難で、排除はさらに困難であることも明らかです。
近年、業界と学界は、これらのアルゴリズムを設計する際に、多様な人々を「部屋の中」に入れる必要があると言うのは、すでに決まり文句です。分野がその段階に到達できれば有益でしょう。しかし現実には、北米のコンピューター科学の博士課程修了者のうち、女性は約23%、黒人およびラテン系の学生は3%にとどまっており、過小代表のグループがまったく代表されていない部屋やアルゴリズムが、今後も数多く存在し続けるでしょう。
だからこそ、私の1998年の頭部追跡システムから得られる根本的な教訓は、今日さらに重要なのです。誤りを犯すことは容易であり、バイアスは気づかれないまま入り込むことが容易であり、部屋にいるすべての人がそれを防ぐ責任を負っているのです。




